从2023年起起头火爆的大说话模型(Large Language Model,LLM),如GPT/Gemini/通义千问/GLM/文心一言/豆包等,经过了一年多的比拼和进化,已经险些涵盖了所有通用性、学问性的知识和理解力;
与之同时,更多传统行业的企业也被吸引到大说话模型的生态中,索求新AI技术为企业带来内容性的刷新。与大模型厂商对通用能力的比拼分歧,传统企业更关注大模型通用能力与自身行业或企业内部的垂直领域的知知趣结合,以满足企业特有业务场景的述求。
垂直领域融合
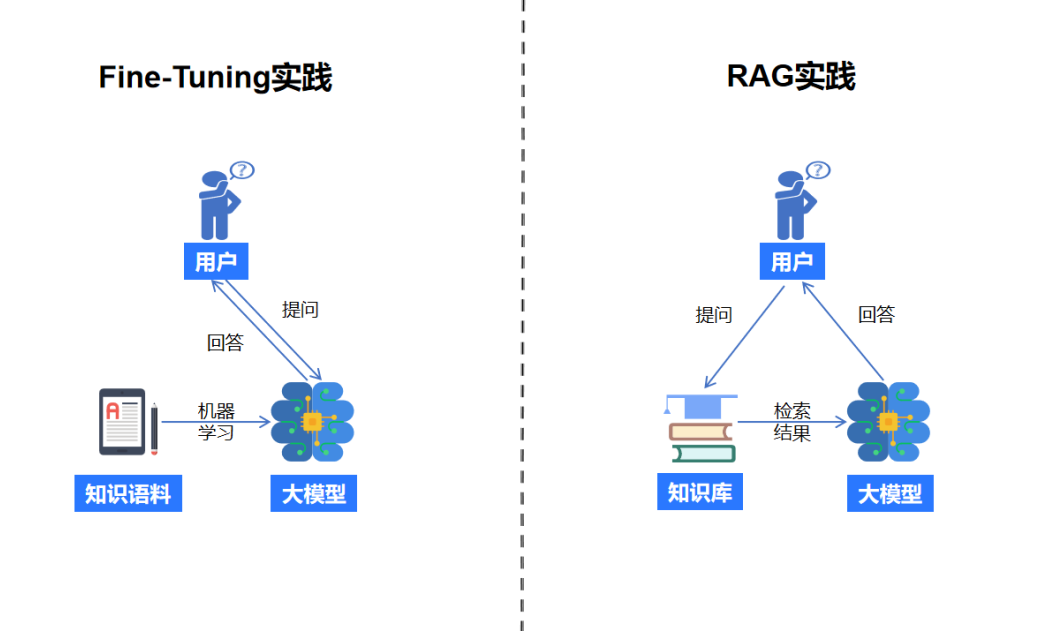
大说话模型对企业垂直领域知识进行融合,主流是两个方向:
Fine-Tuning
将私域知识标注为训练数据,直接对大模型进行增量训练,提升大模型自身的知识储蓄和认知能力,这也是大模型厂商持续提升模型能力的方式之一。
RAG(Retrieval Augmented Generation)
通过在大模型表部构建一套检索系统,解决企业私域知识的提炼和召回问题,并通过prompt让大模型在企业私域知识的布景下返回了局。

与Fine-Tuning分歧,RAG降低了企业对大模型利用的技术门槛,从去年起头一向是受宽大非AI专业企业的热衷。本文从多个RAG实际项目提炼经验,索求若何更好的借助RAG框架为企业进行赋能。
RAG的机遇与痛点
RAG框架的优势在于构建了 Query 和 Generate 的分工机造,在不要求扭转大说话模型Generate能力的基础上,实现与企业私域知识的融合。
若是没有 Query环节,只管当下大说话模型的输入宽度最高已经突破百万tokens,但是也难以一次性覆盖企业全数私域知识量;并且若是用户每次问询都伴随巨量tokens的提醒词,也是一种性价比极低的步骤。所以在当前算力布景下,RAG在大模型利用场景中依然有举足轻沉的职位。
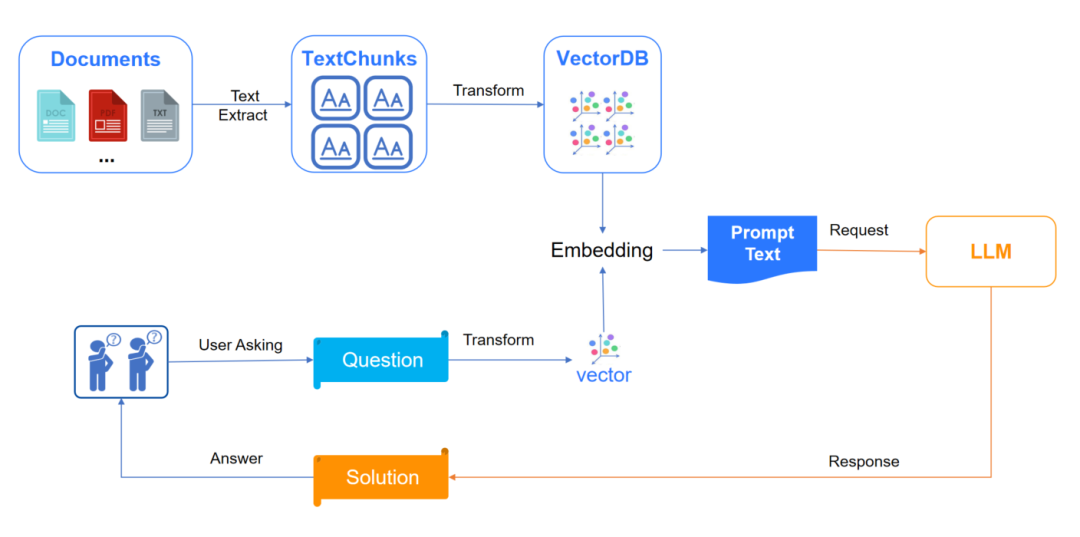
基础的RAG框架图:

然而,企业在实际大模型+RAG框架时,有时辰会发现某些情况并不尽人意,只管大模型的推理和天生能力已经日渐成熟,但是受限于RAG框架下文本片段+向量召回机造下的Query正确率问题,往往造约了大模型自身能力的阐扬。若何更好的协同RAG框架下Query和 Generate的能力,一向是大模型利用的索求方向之一。
RAG的优化实际
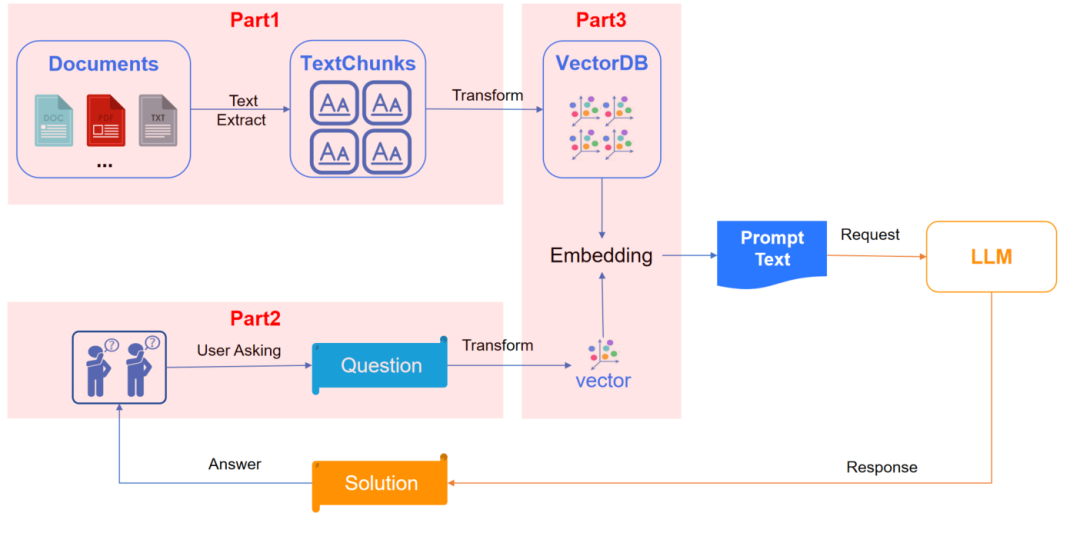
为相识决RAG面对的痛点,我们能够把RAG的Query系统综合为三大环节:知识预处置、用户提问和查问召回。在每个环节下,一步步索求援手改善Query问题的具体实际:

RAG从企业各种类型的文件中提取知识内容,这些内容被切割为知识块,作为检索的最幼单元。知识块内容质量的曲直,直接影响到后续检索和天生回复的正确率。
这个环节我们能够从两个方面进行改善:
1
文档规范
企业能够从文档编写和堆集源头,对内容加以规范,从而使其被RAG更正确的提取和切割。我们提供几种体式的规范参考:
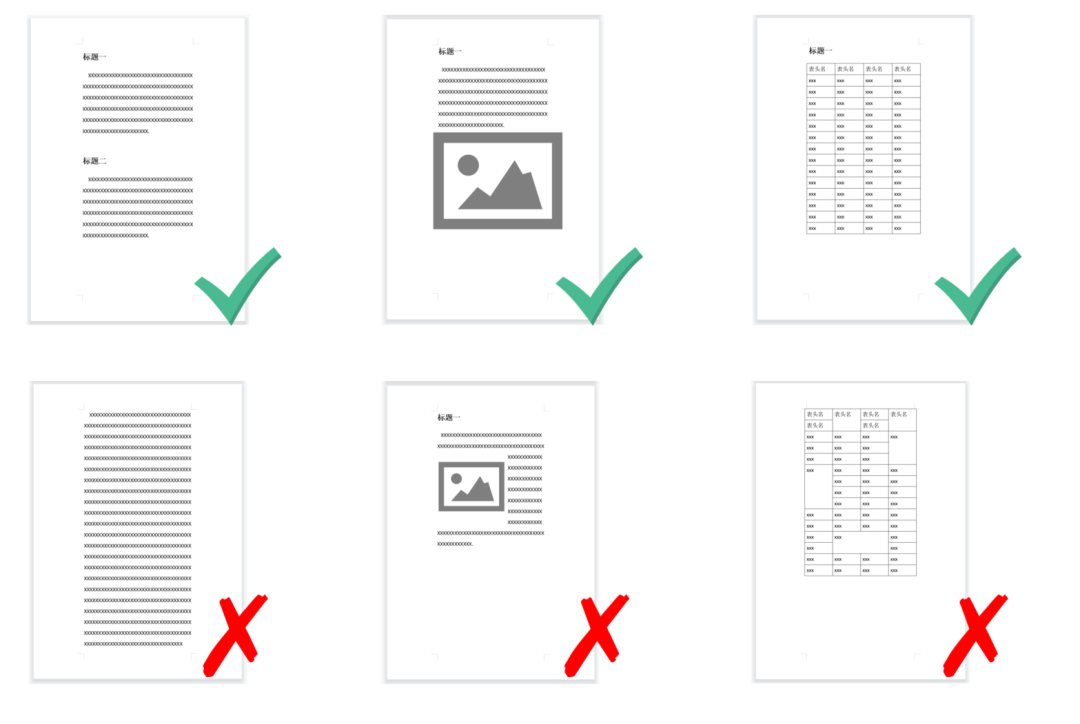
文本:选取多级标题标段落结构,每个末级题眼前的内容不易过长(受切片宽杜装响),每个段落内容必须是齐全和清澈的。
表格:单行表头的表格最佳,行数据预防使用归并单元格的情况。
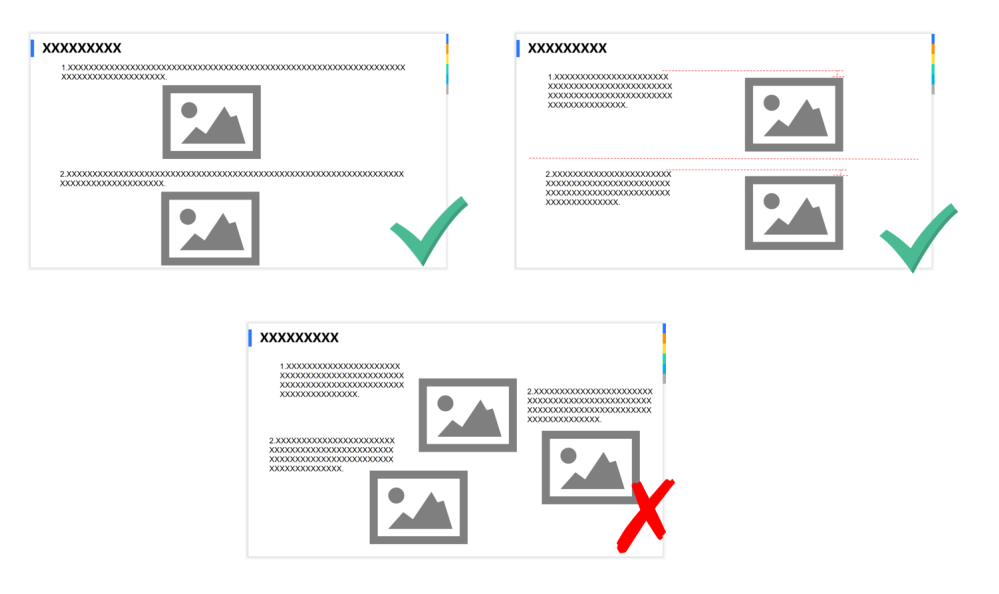
图片:图片与文字的挨次要清澈,通常word/pdf适合文字上、图片下的布局,ppt能够适合文字上、图片下或文字左、图片右的布局。
PDF:PDF通常是用OCR进行文字提取的,对单换行符不敏感,所以对正文的段落划分,建议选取双换行符的方式,便于鉴别段落。
Word内容示例

PPT内容示例

2
内容加工
对于更新频率低的文档,我们能够利用大模型Generate能力对文档内容进行智能化加工,具体实际的规划:
智能提要:对整篇文档的内容进行提要提取,提要能够用于单独匹配用户的问题。
问题预测:对整篇文档或文档片段进行预测问题,天生多个有关的问题短语句,问题短语句能够用于单独匹配用户的问题。
图片加工:仅依附图片高低文关系或ORC技术对图片进行内容推理的方式并不成靠;能够借助大模型对图片的理解能力,将文档内的图片综合为文本描述,从而以文本的大局与用户问题匹配
知识图谱:在大模型的援手下,能够越发智能的提取文档中的沉要实体,并构建三元组大局(实体1 - 关系 - 实体2),搭建多文档的知识图谱。
用户提问的内容和步骤,也是影响RAG正确率的沉要成分,对此,我们能够增长更多显性和隐性的互动环节来改善:
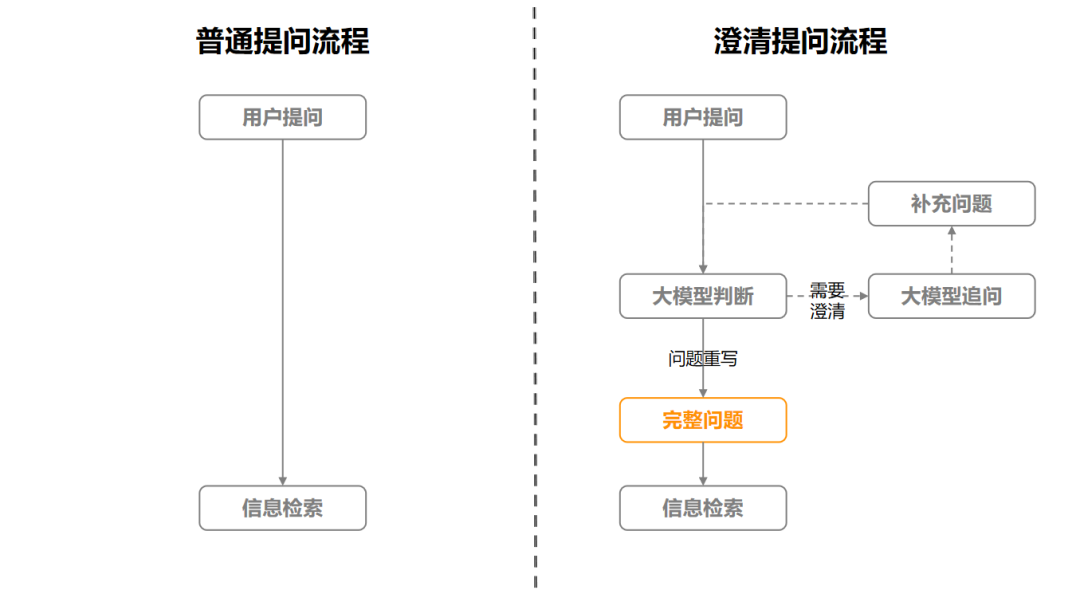
问题澄清
受到传统文本召回的搜索引擎影响,好多用户习惯于用一个词汇或短语进行提问,这种行为会带来更多的匹配不确定性。借助大模型能够急剧构建多种澄清场景,并对用户问题进行判断和追问后,综合成高质量的齐全问题进行信息检索。

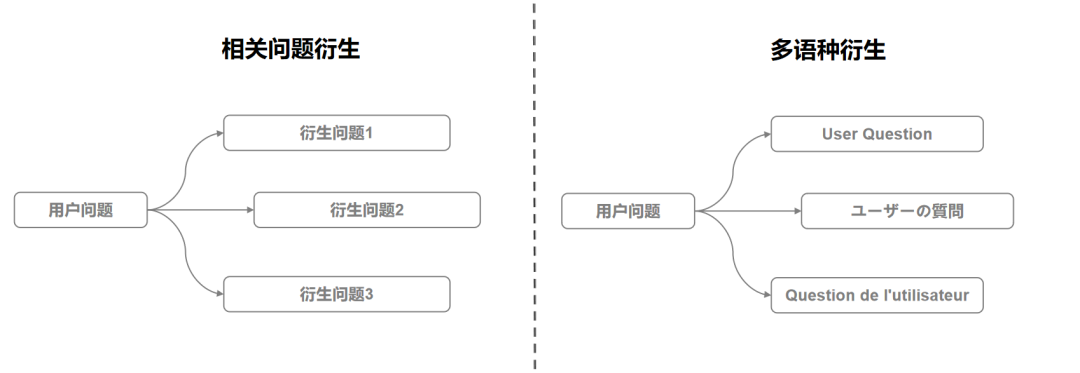
问题衍生
大模型的Generate能力能够将用户的问题进行有关性衍生,这个环节对用户是隐性的。衍生的有关问题能够别离用于检索更多的知识片段,而后排序归并到大模型的prompt里,确保天生回复的全面性。

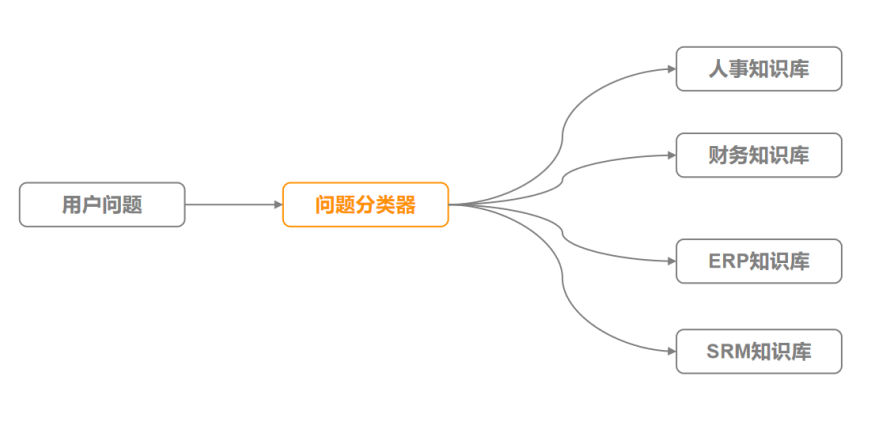
问题分类器
企业内部往往会同时存在多个领域的知识,这些知识在一路被检索时,往往可能会出现滋扰,通过构建一个问题分类器,能够界说分歧的分类指向分歧的知识库。用户在提问时能够率先明确问题分类,也能够借助大模型能力对问题进行自动分类,结合分类路由实现预防分歧领域类似知识的滋扰。

该环节是将用户需要与知识储蓄进行匹配的桥梁,也是RAG框架里沉要的一环,回归到Query的性质。自人类进入信息化社会以来,信息的查问和召回一向是一个持续的话题,我们也能够引入优良的战术和先进的技术来提升召回正确率:
向量模型召回
作为RAG框架的首选,也是查问召回的基础能力,面对长文本的向量匹配,我们能够选择更高维度的向量模型来捕获和比力更多特点值,提升正确率。
目前部门向量模型:
模型 | 维度 |
Bert向量模型 | 768 |
BGE向量模型 | 1024 |
GPT向量模型 | 1536~3072 |
文本向量组合召回
文本召回和向量召回是两种常见的应对海量数据的检索技术,各自拥有怪异的优弊端。为了提升检索成效,能够将这两者进行有效融合。
例如,能够先进行基于关键词的文本召回,而后在此基础上执行向量召回;或者同时进行文本匹配和向量匹配,最后通过综合评分模型进行了局排序和召回。这样的融合战术有助于提高检索的正确性和效能。
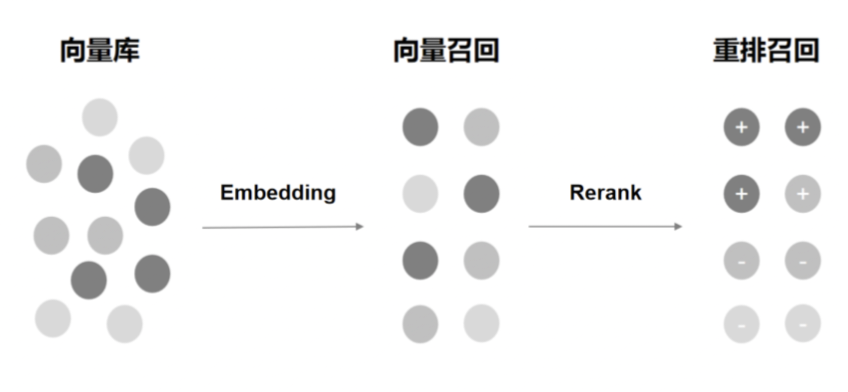
沉排模型召回
沉排模型是一种在低算力、低成本的向量模型与高正确率、高成本的大说话模型之间的折中规划。它结合了向量模型的高效性和大说话模型的语义理解能力,旨在提供更优的检索成效,同时降低推算资源的需要。

沉排模型如:贸易关源的Cohere Rerank模型和开源bge-reranker-large模型等都是当下比力热点的沉排模型。
知识图谱召回
结合对文档预处置的知识图谱构建,我们在查问召回环节能够引用图谱的能力,通过对问题的实体鉴别,进行关系推理和图谱查问;也能够与文本召回和向量召回相结合,形成一个混合召回战术,提升整体的搜索成效。
通过企业内部造度的规范、大模型Generate能力的融入、以及衍生技术工具的升级,使得RAG不单单是一个大模型的表挂系统,而是一个拥有流程化的,将企业私域知识和大模型通用能力深度融合的企业实际。在未来,随着科技的不休进取和用户习惯的不休沉塑,RAG技术也将会为企业带来新的机缘和挑战。

在如今的AI时期,我们已经全面步入了大模型时期。飞速发展的大模型及其衍生技术,在不休推动各行各业的创新与刷新。蕴含RAG在内的这些技术不仅提升了数据处置和决策的效能,更为未来的利用场景启发了无限可能。从智能副手到自动化决策,从个性化推荐到深杜罪义理解,未来的AI将越发智能、矫捷和人道化。瞻望未来,我们有理由相信,随着技术的不休进取,AI将更深刻地融入一飞冲天300倍游戏生涯,扭转一飞冲天300倍游戏工作方式,提升一飞冲天300倍游戏生涯质量。